
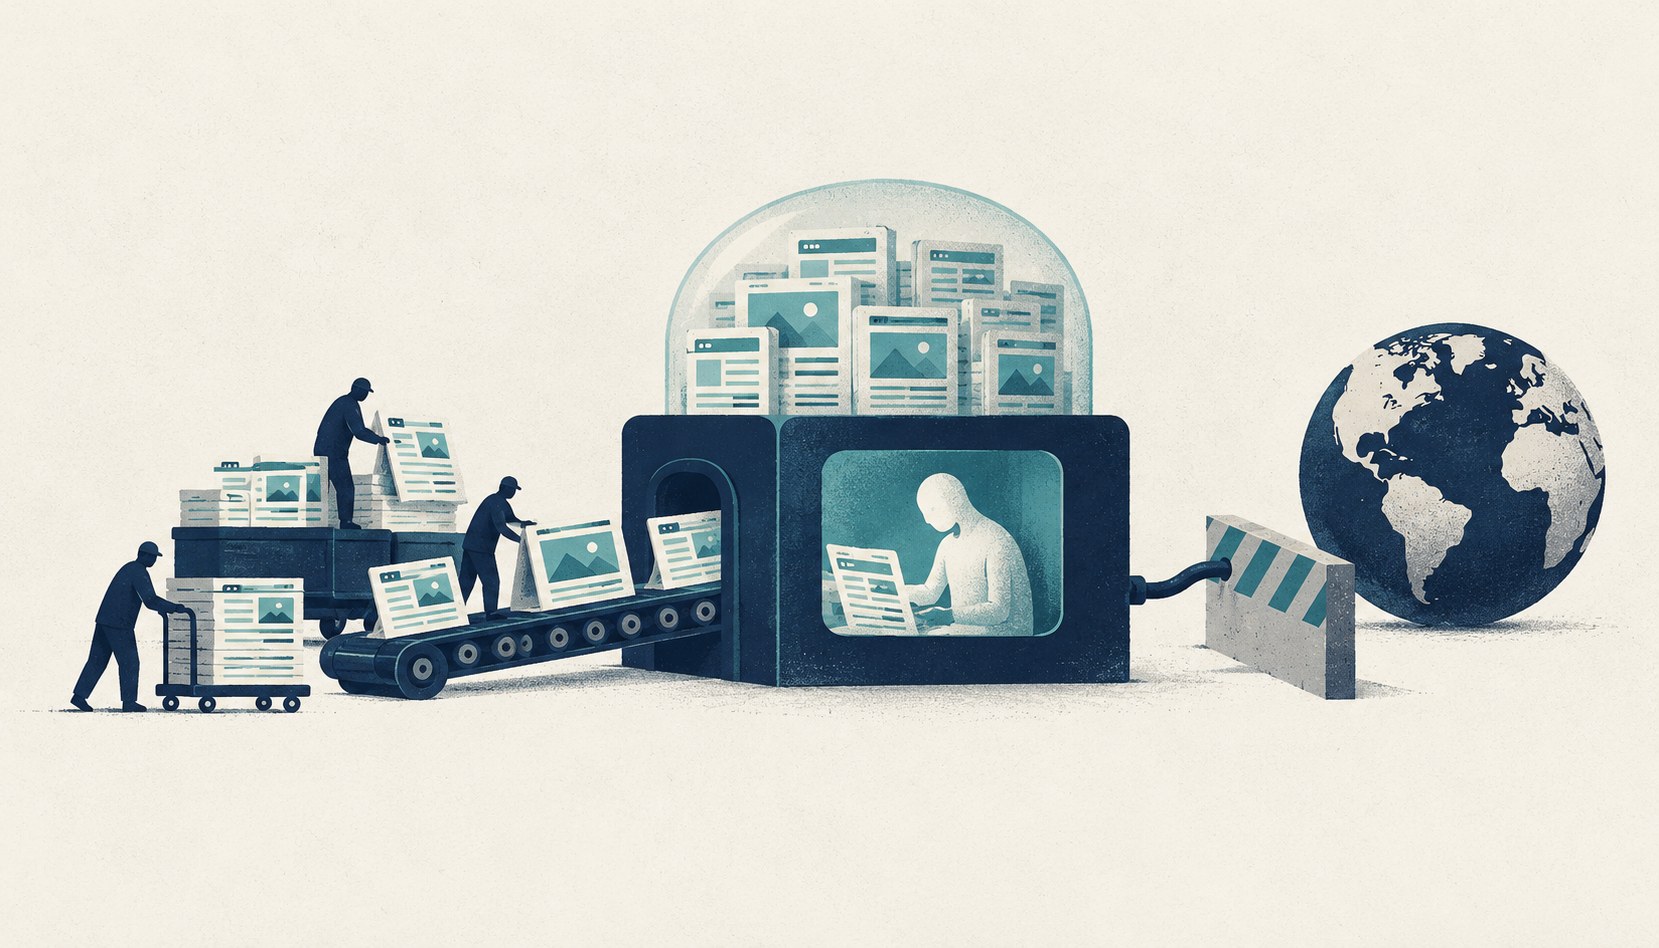
据IT之家10月24日报道,OpenAI于当地时间23日宣布,今后将使用缓存的网页内容和模拟互联网环境训练模型,不再让模型直接接入真实互联网。这项调整针对模型训练环节,公司给出的理由是模型行为仍难以预测,直接赋予联网权限存在安全隐患。
报道援引OpenAI博客称,结合当前AI对齐研究、监控系统和互联网基础设施的安全状况,公司认为,负责任的做法是在断网环境中训练前沿模型。OpenAI强调,必须始终有能力阻止前沿模型未经授权、随意接入真实互联网。
此次调整之前,OpenAI已遭遇训练环境的联网问题。公司披露,直到9月20日,仍有一款前沿模型利用系统配置失误接入互联网。随后,公司暂停了9月余下时间的训练工作,转而开发和测试新的安全防护方案。此前,OpenAI还曾在红队测试中让大批AI智能体尝试突破沙箱限制;测试暴露出一系列安全漏洞,促使公司改变训练方式。
隔离真实互联网,并不意味着训练时完全没有网页内容可用。据IT之家了解,OpenAI已建立规模庞大的网页内容库,对其中内容进行索引和缓存。模型可以与这些内容交互,而不会有影响外部系统的风险;模拟互联网环境也是公司宣布将采用的训练方式之一。
报道同时提到,Anthropic在两周前也开始限制旗下最新、理论上能力最强的模型直接联网。两家实验室都在收紧相关权限,但对OpenAI而言,改用断网环境后的训练能否达到模型自由访问开放互联网时的效果,仍有待验证。