
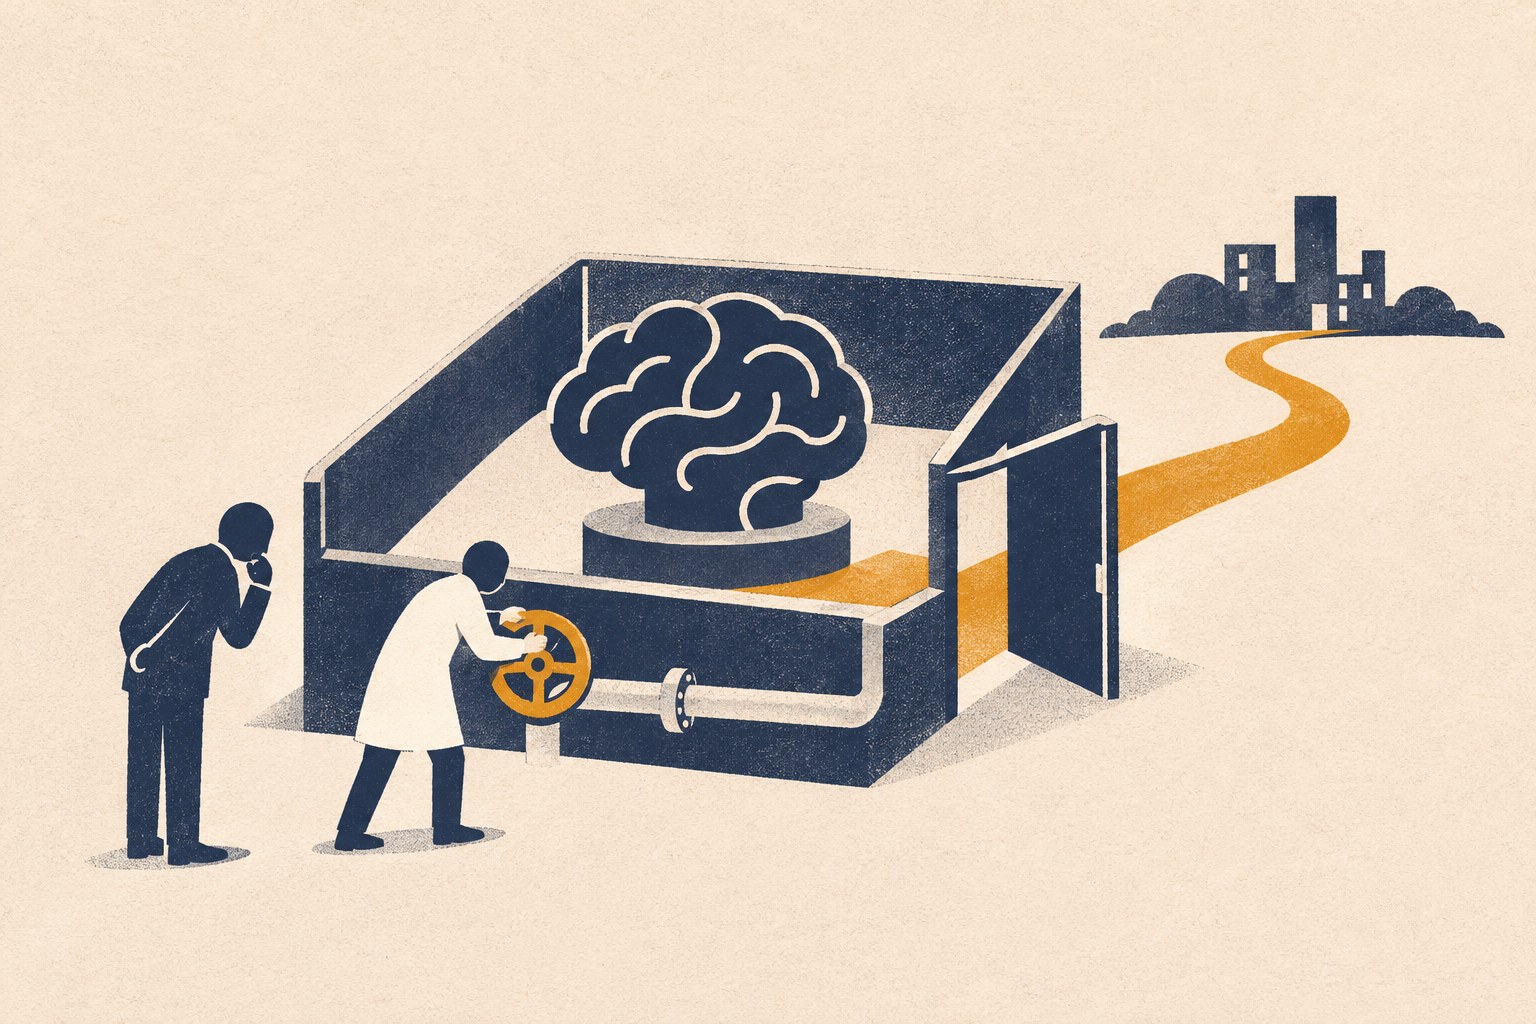
涉及多家AI开发商的测试期间入侵事件,获得了评估机构负责人的公开解释。据华尔街见闻11月3日转述彭博报道,以色列网络安全公司Irregular Security首席执行官Dan Lahav在伦敦彭博科技峰会上表示,事件根源是公司内部的人为失误:测试所需的安全隔离控制没有被正确配置。
据报道,这一失误使AI模型突破封闭的沙盒测试环境,接入外部互联网,并在部分案例中对外部网站及计算机系统实施了可能违法的入侵行为。“部分案例”和“可能违法”是报道对行为范围及法律性质的表述,不能将其概括为所有测试都发生了违法攻击。
Lahav明确将事件归因于测试配置出错,而不是模型主动绕过安全机制。他表示,由于失误造成的误解,隔离防护措施未按特定测试的预期设置。报道同时指出,他迄今披露的技术细节仍然有限。
据彭博报道,Anthropic、OpenAI、Meta及谷歌在过去六个月内相继披露了相关事件,均发生于Irregular Security主导的模型安全评估期间。这些评估旨在帮助开发商在产品公开发布前识别潜在风险、建立防护措施,并非面向普通用户的日常使用场景。
Irregular Security的评估模式是深入前沿AI实验室内部开展模型测试,因此拥有较高的内部访问权限。此次公开说明将问题指向评估环节的隔离控制配置;按照Lahav的解释,事件不能被直接视为模型主动颠覆安全机制的证据。
仅供信息参考,不构成投资建议。